你有没有发现,AI大模型的API价格里面,除了输入输出价格之外,还有一个命中缓存的价格。
而且这个价格往往便宜得离谱,有的只有正常输入价格的十分之一,这是为什么呢?
这背后的技术,就叫 Prompt Cache。
要搞懂它,我们得先回到上一期视频讲的 KV Cache。
如果你没有看过上一期也没关系,我们先来快速回顾一下。
大模型生成内容的时候,是一个 Token 一个 Token 往外蹦的。
因为掩码注意力规定,每个 Token 只能看自己和前面的内容,看不到后面的内容。
所以新 Token 的出现,不会改变历史 Token 的计算结果。
于是我们把每一层历史 Token 的 K 和 V 保存下来,新 Token 来了,只需要拿自己的 Q 去查询这些历史 K、V 就行了。
这就是 KV Cache,用空间换时间,省掉了海量的重复计算。
上期结尾我说,下一期要聊现代大模型里形形色色的注意力计算。
不过上期视频发出去以后,评论区好多小伙伴都在问:这 Prompt Cache 和 KV Cache 名字这么像,到底是不是一回事?
那今天我们就插播一期,把 Prompt Cache 彻底搞懂。
欢迎一键三连不迷路,咱们开始今天的旅程。
KV CACHE 用完就扔了?
故事的开始,还是召唤出我们的老朋友。
假设轩辕做了一个 AI 小助手,专门回答养鹦鹉的问题。
每次调用大模型,小助手都会先塞给AI一大段系统提示词:“你是一位资深的鸟类饲养专家……”,后面再跟上几千字的饲养手册。
然后才是用户的问题:“虎皮鹦鹉能吃苹果吗?”
模型收到这一整段输入以后,第一件事是把所有输入 Token 完整跑一遍,算出每一层的 K 和 V。
这个阶段叫 Prefill,也就是预填充。
接着才进入 Decode,一个 Token 一个 Token 往外生成答案。
上一期讲的 KV Cache,主要就是在 Decode 阶段发挥作用。
但是注意啊。
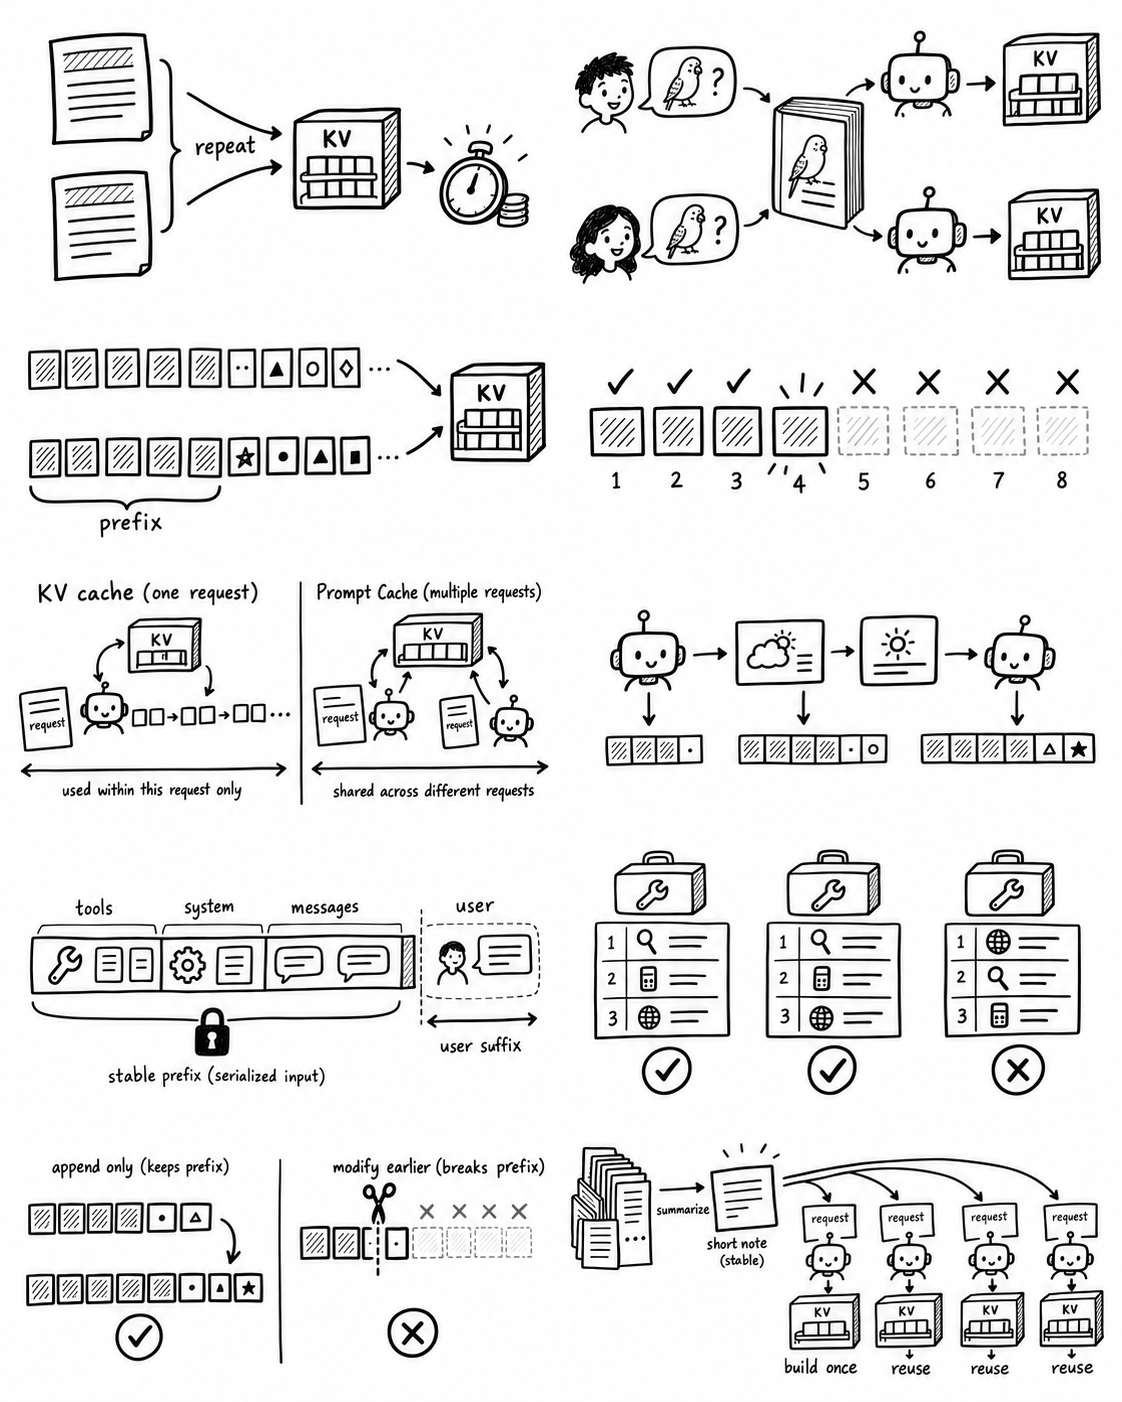
这份 KV Cache,只活在这一次请求里。
回答完“能不能吃苹果”,请求结束,这些 K、V 就被释放掉了。
几秒钟以后,另一个用户来问:“虎皮鹦鹉掉毛怎么办?”
系统提示词一模一样,几千字的饲养手册一模一样,只有最后的问题变了。
可模型又得从第一个 Token 开始,把那几千字重新 Prefill 一遍。
一万个用户来问,这段一模一样的内容就要被算一万遍。
大家想一想,这是不是又是一种重复计算?
能不能把 KV 留到下一次?
既然这几千个 Token 的 K、V 每次算出来都一样,那第一次算完,我们能不能别扔,留给下一次请求接着用?
有的兄弟,有的。
但这里有个关键问题:凭什么说它们“每次算出来都一样”?
还是回到上一期的掩码注意力。
一个 Token 的 K 和 V,只取决于它自己,以及它前面的所有 Token,还有它所在的位置。
后面跟着什么内容,完全影响不到它。
所以只要两次请求的开头部分一字不差,开头这一段每一层的 K、V 就一定完全相同。
反过来,如果中间有一个 Token 变了呢?
比如饲养手册第 100 个 Token 改了一个字。
那第 100 个 Token 的 K、V 会变。
第 101 个 Token 在注意力计算时会看到这个变化,它的结果也跟着变。
一路传下去,从第 100 个 Token 往后,所有缓存全部作废。
所以这种缓存只能命中“从第一个 Token 开始、完全相同的那一段”。
这一段,就叫前缀。
刚才我们设计出来的这个机制,把相同前缀的 KV Cache 跨请求保存下来、下次直接复用,就是今天的主角:Prompt Cache,也叫前缀缓存。
说白了,Prompt Cache 就是 KV Cache 的“跨请求版”。
PROMPT CACHE 和 KV CACHE,到底什么关系?
那这俩到底是什么关系?
先说联系。
它们缓存的是同一种东西:每一层的 K 和 V。
Prompt Cache 存的不是你那段文字本身,而是这段文字算出来的 KV。
再说区别,主要有三点。
第一,作用范围不一样。
KV Cache 管的是一次请求内部,生成第 8 个 Token 的时候复用前 7 个的结果。
Prompt Cache 管的是不同请求之间,这次请求复用上次请求的开头。
第二,省的地方不一样。
KV Cache 主要省的是 Decode,让模型往外吐字更快。
Prompt Cache 省的是 Prefill,前缀越长,省下的时间越多。用户最直观的感受就是首字出来得更快了。
第三,谁来管、怎么收费不一样。
KV Cache 是推理引擎内部的事,用户基本感知不到。
Prompt Cache 要在服务器上存一段时间,涉及存多久、存在哪、命中了怎么算钱,所以各家厂商都把它做成了一个明码标价的功能。
一句话总结:KV Cache 是“这一句话里别重复算”,Prompt Cache 是“这一次和上一次别重复算”。
AGENT 开发:缓存命中率就是钱
如果你在做 Agent,Prompt Cache 就太重要了。
我们来看一个 Agent 是怎么干活的。
用户说:“帮我查一下明天天气,适不适合带鹦鹉出门。”
Agent 先调用大模型,模型决定调用天气工具。
工具返回结果,Agent 把结果追加到上下文里,再调用一次大模型。
模型说还要查一下鹦鹉怕不怕冷,又调用一次工具,再追加,再调用……
注意啊。
每调用一次工具,就是一次全新的请求。
而每一次请求,都要把系统提示词、几十个工具的定义、前面所有的对话和工具结果,全部重新发一遍。
一个任务跑下来几十轮,上下文越滚越长,绝大部分输入 Token 其实都是上一轮已经发过的。
如果每轮都能命中缓存,就只需要为最后新增的那一小段付全价。
所以做 Agent,一定要想办法让前缀稳住。具体有这么几条经验。
第一条:拼出来靠前的部分,要保持不变。
这里有个容易误会的地方。
调 API 的时候,工具定义、系统提示词、历史消息,是请求 JSON 里的不同字段。
JSON 里这几个字段谁写在前、谁写在后,其实无所谓。
因为模型根本不认 JSON。
服务端收到请求以后,会按自家固定的模板,把这些东西拼成一条完整的 Token 序列,再送进模型。
缓存比对的,是这条拼好的序列的前缀。
比如 Anthropic 的文档就写得很明确,拼接顺序是:工具、系统提示词、消息。其他家的模板细节略有不同,但大体思路差不多。
所以重点不是你怎么排字段,而是拼出来以后靠前的那部分,每次都要一模一样。
系统提示词里也别塞每次都在变的东西,比如用户 ID、随机数、每次都不一样的检索结果。它们一变,后面的缓存全部作废。
第二条:工具定义不要动。
拿 Anthropic 来说,工具定义拼在最前面,是整个前缀的地基。它一改,后面系统提示词和历史消息的缓存全部跟着失效。
有的框架每次请求都动态增删工具,或者把工具列表从一个无序集合里取出来,列表里工具的先后时不时变一下。
对人来说是同一批工具,可拼出来的 Token 序列已经不一样了,对缓存来说,就是一个全新的前缀。
所以工具列表尽量一开始就定好,每次生成出来的内容都要保持完全一致。
第三条:只追加,不修改历史。
Agent 跑着跑着,你可能想回头改一下第三轮的工具结果,或者删掉中间某条消息。
改了第三轮,第三轮往后的缓存就全没了。
说到这儿,我得坦白一个自己踩过的坑。
我刚开始学 Agent 开发的时候,总觉得上下文太长太浪费了。
尤其是工具调用,有时候参数特别长,返回结果更长,动不动几千上万个 Token。
于是我就想了个“聪明”的办法:把历史上下文里那些超长的工具参数和结果截断,只留个开头。
又怕截断影响效果,所以最近几轮就不裁剪,保留原样。
当时我还觉得自己挺机智的。
但大家想一想,这个“最近几轮”是不是一个滑动窗口?
每多交互一轮,窗口就往后挪一格,原来不裁剪的那一轮,就掉进了要被裁剪的范围。
它的内容一被截断,从这个位置往后,前缀全变了。
也就是说,几乎每一轮请求,都有一段历史被我亲手改掉,缓存就这么一轮接一轮地失效。
后来我盯着账单里的缓存命中率,才发现问题出在这里。
我把裁剪干脆取消掉,缓存命中率瞬间就上去了。
你说神奇不神奇,不裁剪以后,上下文明明更长了,可因为绝大部分都命中了缓存,实际花的钱反而降下来了。
所以历史消息尽量只往后追加,要补充新的指令,也追加一条新消息,而不是回头改前面的内容。
第四条:上下文压缩要想清楚代价。
上下文太长,很多 Agent 会做压缩:把前面几十轮对话总结成一小段摘要,替换掉原来的内容。
这一换,从被替换的位置开始,前缀全变了。
压缩之后的第一轮请求,基本要重新写一遍缓存。
所以压缩不能太频繁,最好是攒到一定长度再做一次大的。压缩完以后新的前缀尽量保持稳定,让后面几十轮继续命中。
另外,中途切换模型、切换推理强度这类参数,在很多厂商那里也会导致缓存失效,这个要看各家文档。
回顾总结
最后我们来总结一下。
KV Cache 只活在一次请求里,请求结束就扔了,下一次请求相同的开头还要重新 Prefill。怎么办?
那就把相同前缀的 KV 跨请求保存下来。
于是有了 Prompt Cache。
为什么只能缓存前缀?
因为掩码注意力下,一个 Token 的 K、V 只取决于它和它前面的内容,前面任何一个 Token 变了,后面全部作废。
Agent 每调用一次工具就是一次新请求,上下文越滚越长怎么办?
那就让前缀稳住:拼出来靠前的部分保持不变,工具定义别乱动,历史只追加不修改,别搞滑动窗口式的裁剪,上下文压缩别太频繁。
上下文短一点不一定更省钱,前缀稳住了,长一点反而更便宜。
你看,Prompt Cache 并不是什么全新的黑科技。
它就是把上期的 KV Cache,从一次请求里,延长到了多次请求之间。
而能做到这一点,靠的还是 Transformer 里那条最朴素的规矩:只能看前面,不能看后面。
不过,不管是 KV Cache 还是 Prompt Cache,缓存的都是每一层、每一个 Token 的 K 和 V。
上下文一长,这份缓存本身就大得吓人,注意力的计算量也还在。
那现代大模型是怎么从注意力本身下手,把它变小、变快的?
下一期,我们终于要来聊聊那些形形色色的注意力计算了。
OK,以上就是今天视频的全部内容了。
如果觉得还不错,别忘了一键三连支持轩辕一波哦。
点赞越多,更新越快。
我是轩辕,我们下期再见。