你有没有好奇过,GPT 这样的 AI 大模型,到底是如何理解我们的提示词,然后一个字一个字蹦出来回答问题的?
上一期视频,我们学习了Transformer架构的AI大模型是如何一个token一个token的蹦出字来。
我们先来快速回顾一下:
在Transformer架构下,输入进去一句话会被分词器拆分成一个个的token,每一个token经过词嵌入变成一组数字组成的高维词向量,这个高维词向量就包括了这个token在语言中的语义信息。
再叠加位置编码后,这个词向量就包含了token在文字序列中的先后顺序信息。
接着每个token的词向量经过训练好的线性变换变成QKV三个新的向量,Q 用来发起查询,K 用来和查询匹配,V 用来真正传递信息。然后让这些token用各自的Q去匹配包含自己在内所有token的K,最后按匹配之后得到的权重取V做加权求和得到新的向量,这个新的向量融合了上下文的信息,表达的就不再只是这个词单独的意思,这个过程就是注意力计算。
而语言间的规律往往蕴含了多种不同维度的信息,所以一组QKV不够,需要增加多组不同的QKV形成多头注意力。
完成注意力计算之后再接入一个FFN前馈神经网络,把注意力计算的结果进行更深入的学习。
注意力计算和FFN两个模块组成了Transformer中基本的block块,真正的模型中还会再叠加很多层这样的块形成一个更深的网络。
当网络规模达到一定程度之后,神奇的事情发生了,这套网络就能学习人类语言中的规律,通过不断预测下一个token的方式,来为我们写文章、写代码了。
上一期视频的末尾,我给大家留了一个问题:现在的大模型,上下文动不动就是几十万,甚至一百万 Token。如果还是按照最原始的注意力计算,这计算量将是天文数字。该如何解决这个问题呢?
今天这一期,我们来学习其中一个非常重要的优化手段:KV Cache。
这个词相信大家一定不陌生,这到底是个什么东西?今天咱们通过动画彻底搞懂。
欢迎一键三连不迷路,咱们开始今天的旅程。
到底重复算了什么?
故事的开始,还是召唤出我们的老朋友,来看下面这句话:
轩辕 / 养了 / 一只 / 黄色 / 的 / 虎皮 /
上一期我们已经知道,每一个 Token 进入注意力模块以后,都会根据自己的输入向量,通过线性变换得到 Q、K、V。
Q 表示“我想找什么”。
K 表示“我这里大概有什么”。
V 表示“我真正携带了什么信息”。
所以“轩辕”有自己的 Q、K、V,“养了”也有,一直到“虎皮”,每个 Token 都有一套。
接下来,每个 Token 拿自己的 Q 去和能看到的 K 做匹配,再根据注意力权重,从对应的 V 里面读取信息。
最后得到一份融合上下文的新向量。为了讲述方便,我们把这个 Attention计算后得到的新向量叫 O。
比如以“虎皮”这个token来说。
它拿 Q虎皮 去匹配前面的 K,再按照得到的权重加权这些 V,最后得到 O虎皮。
O虎皮 再经过 FFN 进一步处理,得到这一层的最终输出,然后进入下一层 Transformer。
就这样一层一层往上走,假设最后模型预测出了“鹦鹉”。
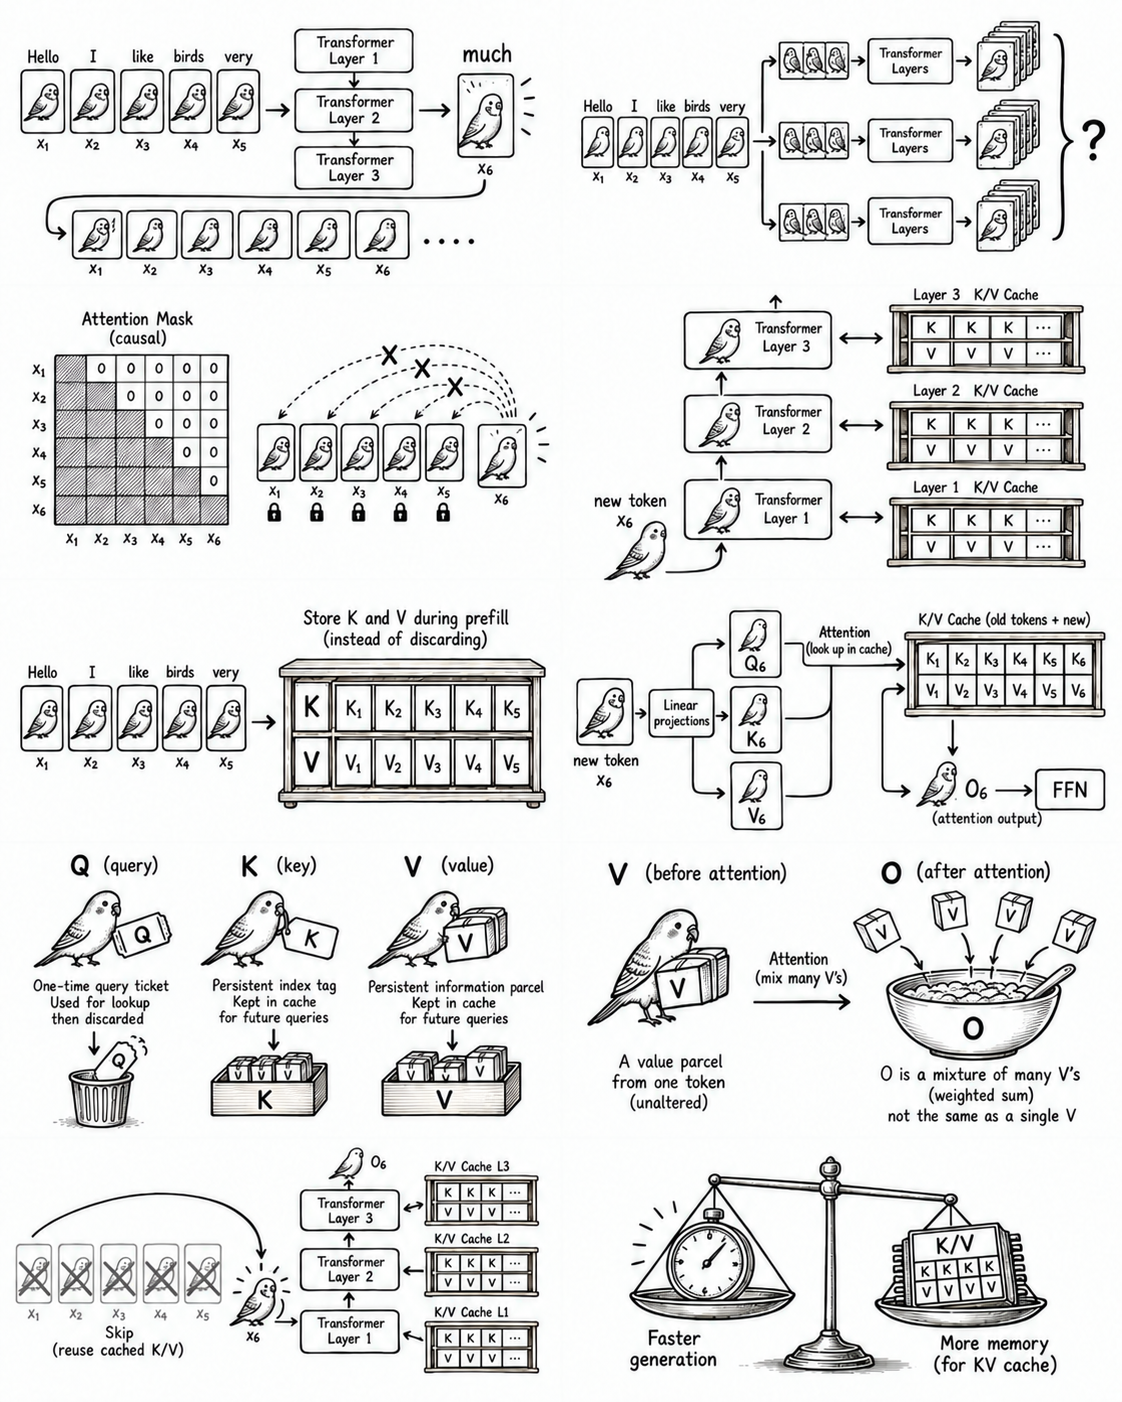
接下来,我们需要根据 “轩辕 / 养了 / 一只 / 黄色 / 的 / 虎皮 / 鹦鹉” 去预测下一个token。
如果采用最笨的办法,我们就得把这七个 Token 全部重新送进去。
第一层重新算七个 Token 的 Q、K、V,重新做 Attention,重新得到七个 O,再重新跑七次 FFN。
第二层再来一遍。
一直到最后一层,生成第8个token。
而生成第8个 Token 以后,上面整个过程还得再从头来一遍。
每生成一个token,上面这个过程都得从头来一遍……
大家想一想,这里面有没有重复工作?
历史 Token 的结果真的会变吗?
我们来看“虎皮”这个token。
第一次预测“鹦鹉”的时候,它已经算出了 Q虎皮、K虎皮、V虎皮。
Q虎皮 去查询前面的 K,再读取对应的 V,得到 O虎皮。
O虎皮 又经过 FFN,得到这一层的输出。
现在后面多了一个新 Token:“鹦鹉”,继续来预测下一个token。
那大家想一下,第二次在做预测的时候,O虎皮 会不会变?
回忆一下上一期讲过的掩码自注意力。
像 GPT 这样的生成式大模型,使用的是掩码注意力:每个 Token 只能看自己和前面的内容,不能看它后面的内容。
所以“虎皮”可以看到:
轩辕、养了、一只、黄色、的、虎皮。
但是它看不到后面的“鹦鹉”。
哪怕“鹦鹉”后来真的生成出来,“虎皮”也不会看到它。
所以新 Token 的出现,并不会改变“虎皮”原来能看到的内容。
既然输入关系没变,O虎皮 就不会变。
O虎皮 不变,后面的 FFN 参数也没变,那 FFN 的结果当然也不会变。
同样的道理也适用于轩辕、养了、一只、黄色、的。
所以“鹦鹉”出现以后,前面六个历史 Token 的 Attention 和 FFN 结果其实全都还是原来的结果。
既然完全一样,为什么还要重新算呢?
这里历史token的计算完全可以省下来。
可下一层不是还需要它们吗?
看到这里,可能有小伙伴会发现一个问题。
你说历史 Token 的 O 和 FFN 都不用重新算。
但 Transformer 可不止一层啊。
第一层 FFN 的输出,是第二层的输入。
第一层不重新跑,第二层怎么办?
这个问题非常关键。
我们继续看“虎皮”这个token。
第一次处理它的时候,它已经完整跑过第一层:
Attention → O虎皮 → FFN → 第一层输出。
这个输出接着进入第二层。
到了第二层,它又会经过第二层自己的线性变换,产生第二层的 K虎皮 和 V虎皮。
第三层、第四层也是一样。
也就是说,当“虎皮”第一次完整穿过 Transformer 时,它其实在每一层都会产生一份属于这一层的 K 和 V。
假设模型有 40 层,那就会有:
第1层的 K虎皮、V虎皮;
第2层的 K虎皮、V虎皮;
……
第40层的 K虎皮、V虎皮。
现在新的“鹦鹉”来到第 20 层。
它真正需要历史“虎皮”的什么东西?
不是第 19 层的 O虎皮,也不是让“虎皮”重新跑一遍 FFN。
它真正需要的是第 20 层已经算好的 K虎皮 和 V虎皮。
因为“鹦鹉”只需要拿自己的 Q鹦鹉 去匹配这一层历史 Token 的 K,再读取对应的 V。
那如果这些 K 和 V 第一次算出来的时候,我们就把它存储起来呢?
把以后还会用到的东西留下来
第一次处理:
轩辕 / 养了 / 一只 / 黄色 / 的 / 虎皮 /
的时候,反正每一层的 K 和 V 都已经算出来了。
那就别扔。
第一层保存第一层的历史 K、V。
第二层保存第二层的历史 K、V。
一直保存到最后一层。
现在“鹦鹉”来了。
进入第一层以后,只计算它自己的:
Q鹦鹉、K鹦鹉、V鹦鹉。
然后 Q鹦鹉 直接去查询已经保存好的:
K轩辕、K养了、K一只、K黄色、K的、K虎皮,
再加上自己的 K鹦鹉。
得到权重以后,再读取对应的历史 V 和自己的 V鹦鹉。
最后只得到一个新的 O鹦鹉。
注意啊。
这里没有重新计算 O轩辕、O养了、O一只、O黄色、O的、O虎皮。
真正新增的只有 O鹦鹉。
所以 FFN 也只处理 O鹦鹉。
接着“鹦鹉”进入第二层。
第二层还是一样:计算“鹦鹉”自己的 Q、K、V,直接查询第二层之前保存好的历史 K、V,再得到这一层的 O鹦鹉,跑一次 FFN。
就这样,“鹦鹉”一个 Token 从第一层一路跑到最后一层。
而前面的六个历史 Token,再也不用重新穿过整个 Transformer。
这一下,计算量就要小得多了。
我们保存下来的这些历史 K 和 V,就是大家耳熟能详的KV Cache。
第一次处理历史 Token 时,把每一层产生的 K 和 V 保存下来。
以后每生成一个新 Token,只计算新 Token 自己的 Q、K、V,再用它的 Q 去查询这一层已经保存的历史 K 和 V。
为什么不是 QKV Cache?
有小伙伴可能会问:
每个 Token 明明都有 Q、K、V。
为什么只缓存 K 和 V?
Q 呢?
还是看“虎皮”这个token。
Q虎皮 是“虎皮”自己做 Attention 时使用的查询向量。
它拿着自己的 Q 去匹配历史 K,算出 O虎皮以后,Q虎皮 的任务就完成了。
以后“鹦鹉”来了,用的是 Q鹦鹉。
再来一个新 Token,用的又是这个新 Token 自己的 Q。
未来没有谁会再拿 Q虎皮 出来查询一次。
所以历史 Q 是一次性用品,用完就可以扔。
但 K 和 V 不一样。
未来每一个新 Token,都可能拿自己的 Q 来匹配 K虎皮,并读取 V虎皮。
所以:
Q:我现在想找什么——用完就走。
K:我这里有什么——留着给未来匹配。
V:我真正能提供什么——留着给未来读取。
这就是为什么它叫 KV Cache,而不是 QKV Cache。
缓存的 V 是 V虎皮,还是 O虎皮?
这里还有一个特别容易搞混的问题。
既然已经算出了 O虎皮,为什么不缓存 O虎皮?
因为 V虎皮 和 O虎皮 代表的不是一回事。
V虎皮 可以理解成:
“虎皮这个 Token 能提供给别人什么信息。”
而 O虎皮 是:
“虎皮拿着自己的 Q,从大家那里拿回来并汇总后的信息。”
一个是“我能给别人什么”。
一个是“我从别人那里拿回了什么”。
现在“鹦鹉”来了。
它要根据自己的 Q鹦鹉 判断应该从“虎皮”这里读取多少信息。
所以它需要的是 K虎皮 和 V虎皮。
O虎皮 是站在“虎皮”自己的查询视角得到的结果,不是“鹦鹉”应该直接拿来用的 Value。
所以 KV Cache 缓存的确实是 Attention 计算之前的 K 和 V,不是最后的 O。
它到底节省了哪些计算?
有了KV Cache,很多运算都可以省下来了。
KV Cache 最直观节省的是:
我们用空间换时间,把每一层历史 Token 的 K 和 V 缓存起来,就不需要在decode阶段每次吐一个新token都再为这些历史token做线性变换去临时计算它们的K和V了。
但如果你认为它只省了这两个线性变换,那就大大低估它了。
真正更大的节省还在后面:
因为历史 Token 看不到未来,所以新 Token 的出现不会改变历史 Token 原来的 Attention 结果。
于是历史 Token 的 Q 不用重新算。
历史 Token 的 Attention 不用重新算。
历史 Token 的 O 不用重新算。
历史 Token 的 FFN 也不用重新算。
甚至历史 Token 后面几十层的整条计算路径,都不需要再重新跑。
所以在 Decode,也就是模型一个 Token 一个 Token 正式往外生成的时候:
真正需要完整穿过几十层 Transformer 的,只有新 Token。
历史 Token 不再重新穿过模型。
它们只以每一层 KV Cache 的形式留在那里,等待新 Token 查询。
这才是 KV Cache 真正厉害的地方。
回顾总结
最后我们来总结一下。
模型第一次处理:
轩辕 / 养了 / 一只 / 黄色 / 的 / 虎皮 /
这些 Token 时,它们完整穿过 Transformer,每一层都产生自己的 Q、K、V,做 Attention,得到 O,再经过 FFN。
最后预测出:
鹦鹉。
如果下一次预测又把历史 Token 全部重算一遍,会产生大量重复计算。
但因为因果注意力规定历史 Token 看不到未来,所以“鹦鹉”的出现不会改变历史 Token 原来的 Attention 和 FFN 结果。
于是我们只需要把未来还会用到的历史 K 和 V,在每一层保存下来。
新 Token 到来以后,只让新 Token 自己穿过整个 Transformer,并在每一层查询已经保存好的历史 K、V。
这套机制,就是 KV Cache。
有了KV Cache,不仅可以节省每一次都临时为历史token计算 K、V 的线性变换运算量。
更重要的是它让历史 Token 的 Attention、O、FFN,以及后续整条 Transformer 计算链都不用再重跑。
这就是为什么今天的大语言模型在一个 Token 一个 Token 往外生成的时候,可以避免海量的重复计算。
不过即便有了KV Cache,想要让大模型支持百万级的上下文,依然困难重重。
首先是缓存爆炸问题。每一层都有自己的KV Cache,几十上百层之后,百万级的上下文,这缓存所需要的存储空间将会非常庞大。
除了存储空间巨大,还有计算量同样巨大。如果按照标准的注意力计算,两两token之间都要进行注意力计算,当上下文来到百万量级,即便有了KV Cache,每一次新token的计算量同样是天文数字。
光有KV Cache还不够,我们还需要新的办法,那到底是什么呢。
欢迎大家继续追更,我们下一期来揭晓现代大模型中这些形形色色的注意力计算。
OK,以上就是今天视频的全部内容了。
如果觉得还不错,别忘了一键三连支持轩辕一波哦。
点赞越多,更新越快。
我是轩辕,我们下期再见。