你有没有发现一个现象:有些大模型宣传支持百万上下文,但实际用到五六十万,就已经开始降智了?
为什么上下文越长,模型越容易犯糊涂?
大模型面对越来越长的上下文,又是怎么避免被注意力计算给拖垮的?
今天这期视频,我们就来彻底聊清楚。
要搞清楚这些问题,我们需要先快速回顾一下Transformer的基本工作原理。
如果还不清楚Transformer是什么的同学,强烈推荐去我主页翻翻这期视频看一下。这期视频在B站和Youtube都获得了大量观众的好评。
在 Transformer 里,每个 Token 都会生成自己的 Q、K、V。Q 去和所有 Token 的 K 做匹配,算出权重,再按权重去读取 V,得到一个融合了上下文信息的新向量,这个过程就是注意力计算。
而模型生成回答的时候,是一个 Token 一个 Token 往外蹦的。为了避免重复计算,我们把历史 Token 的 K 和 V 存了下来,这就是 KV Cache。
但是上期视频最后我们也说了:就算有了 KV Cache,想让大模型撑起百万级的上下文,依然困难重重。
注意力的计算量越来越大,KV Cache 也越来越大,大到连显存都装不下。
今天这一期,我们就来把这个坑填上。
还是让你们的老朋友轩辕和他的虎皮鹦鹉,陪我们走完整期视频。
欢迎一键三连不迷路,咱们开始今天的旅程。
100 万 TOKEN,两两计算有多夸张?
故事的开始,我们先来算一笔账。
还是这句话:
轩辕养了一只虎皮鹦鹉,它有绿色的羽毛。
模型处理“它”的时候,会拿“它”的 Q,去和每个 Token 的 K 做匹配,发现“虎皮鹦鹉”的分数特别高,于是重点读取它的 V。
句子里的每一个 Token,都在做同样的事情:和其他所有 Token 都匹配一遍。
这套机制很强大,两个 Token 隔得再远,也能直接建立联系。
但你想想,这得是多大的计算量?
10 个 Token,两两匹配,10×10,一百次。
100 个 Token,100×100,一万次。
Token 数量涨 10 倍,计算量就涨 100 倍。
那 100 万个 Token 呢?
100 万乘以 100 万,一万亿次。
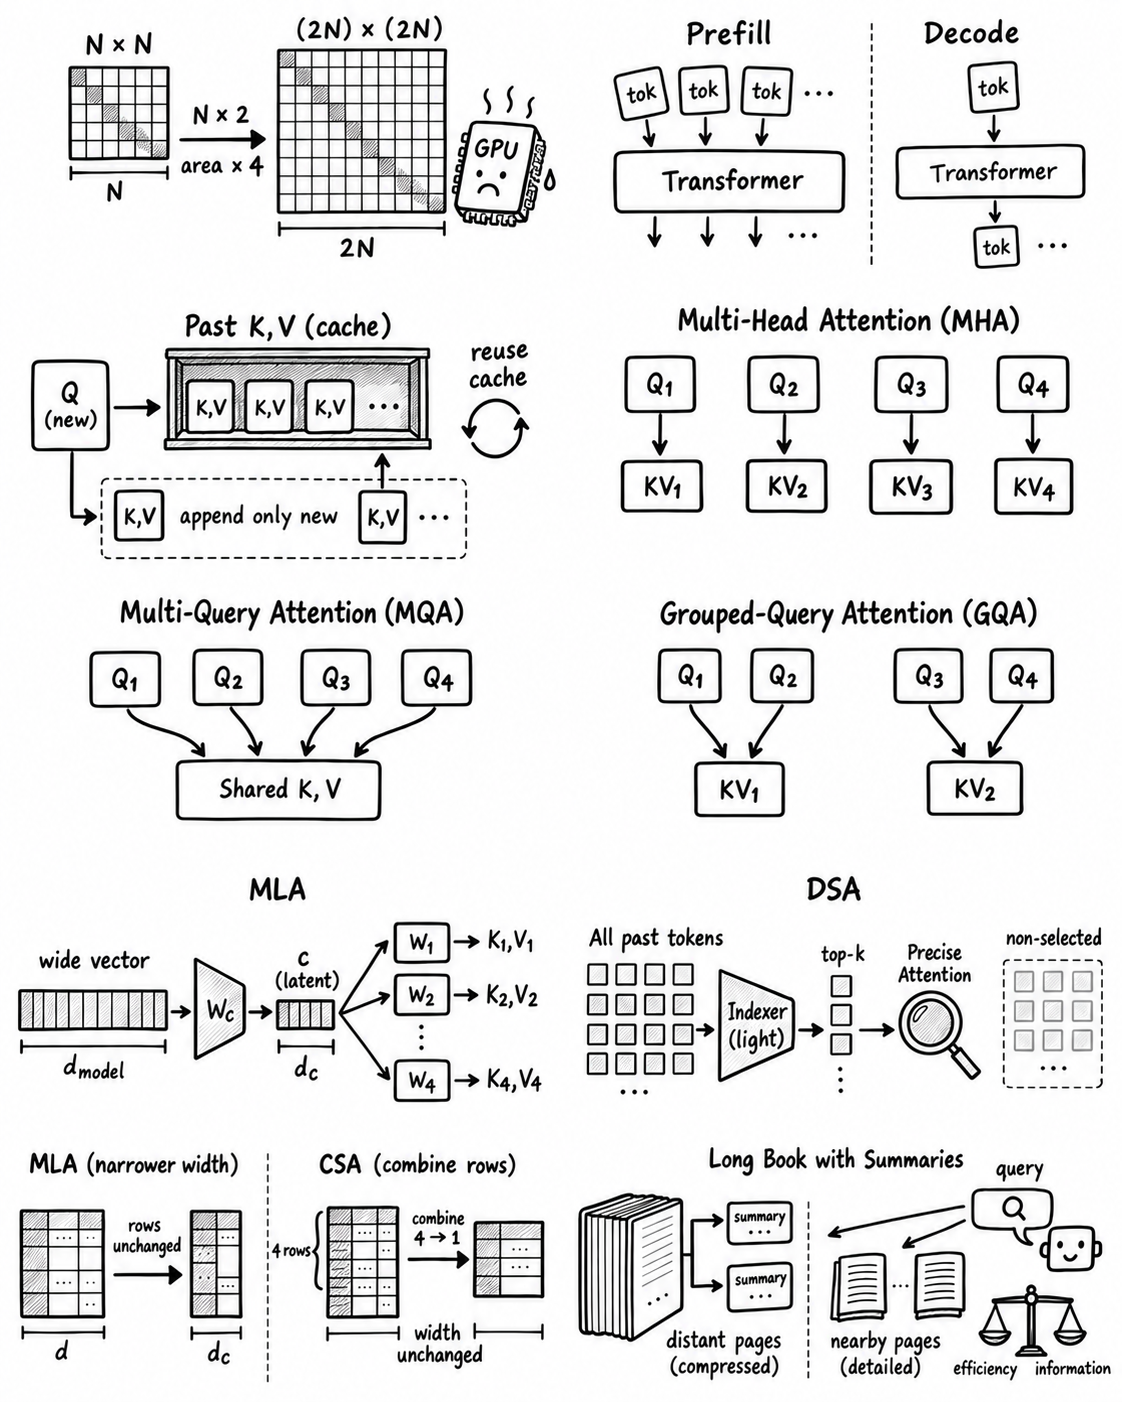
而且这还只是一层、一个头的账。模型有几十层,每层还有几十个头。
真要老老实实这么算,GPU 都得干冒烟。
所以必须想办法省。
不过在动手之前,我们得先补一个前置知识。
你给大模型发一个问题,到它开始一个字一个字回答,中间其实经历了两个完全不同的阶段。
PREFILL 和 DECODE:先读题,再写答案
假设我问:
轩辕养了一只虎皮鹦鹉,它的羽毛是什么颜色?
这些文字先被分词器拆成 Token,再变成词向量,送进 Transformer。
第一个阶段,叫 Prefill,预填充。
Prompt 里所有的 Token,会一起冲进 Transformer。每一层,都会用这一层自己的参数,给每个 Token 算出这一层自己的 Q、K、V。
注意啊,是每一层都有自己的 QKV。
假设模型有 32 层,第一层有第一层的 QKV。第二层的输入,是第一层加工之后的结果,所以第二层又会算出第二层自己的 QKV。一直到第 32 层。
等整个 Prompt 都处理完,模型终于吐出了第一个新 Token,比如“绿色”。
接下来进入第二个阶段,Decode,解码。
“绿色”出来了,接着预测“的”,再预测“羽毛”……
这个阶段没法一口气做完。因为第二个字写什么,得等第一个字真的写出来才知道。
所以你可以这么理解:
Prefill,是模型在读题。
Decode,是模型在一个字一个字写答案。
读题可以一口气读完,写答案却只能一笔一划来。
这个区别,后面会很有用。
算过的别再算:KV CACHE
好,有了这个前置知识,我们先来看第一招。
这一招大家已经认识了,KV Cache。之前的视频里我们详细讲过,这里就提一嘴。
历史 Token 的 K 和 V,算一次就够了。Prefill 的时候把每一层的 K、V 存起来,Decode 的时候只算新 Token,直接去查缓存,不用每写一个字,就把前面十万个 Token 重新算一遍。
到这里,第一笔浪费就省掉了。
但新的问题又来了:每生成一个新 Token,缓存就要往后长一截,它会越来越大。
缓存太大了怎么办?MQA、GQA
每一层都有一份自己的缓存,每层的注意力又有很多个头。
上下文来到 10 万、100 万 Token,显存里要存的历史 K、V,会大得吓人。
而且麻烦还不只是“放不放得下”。
Decode 的时候,每写一个字,都得把这些历史 K、V 从显存里读一遍。这时候 GPU 往往不是算不过来,而是大部分时间都花在搬数据上,在等数据。
那怎么办?
第一反应当然是:能不能少存一点?
可到底从哪儿下手呢?
我们回到之前讲过的多头注意力。
一句话里,同时存在指代、修饰、动作等很多种关系,所以 Transformer 会安排多个头,从不同角度去看同一句话。
假设模型有 32 个头。在最经典的多头注意力里,每个头都有自己的一组 Q、K、V:32 个 Q,32 个 K,32 个 V。
这种做法有个名字,叫 MHA,Multi-Head Attention。
别被缩写吓到,它就是我们之前讲过的那个经典多头注意力。
为什么要 32 个 Q?因为一句话里的关系实在太多了。有的头盯着“它”和“虎皮鹦鹉”,有的头盯着“绿色”和“羽毛”。多个提问的角度,非常有价值。
但问题来了:32 个不同的提问角度,真的需要 32 套各自独立的 K 和 V 吗?
我们把这 32 个头想象成 32 个观察员。有人问这只鹦鹉是谁养的,有人问羽毛是什么颜色,有人问它是什么品种。
MHA 就像是给每个观察员,都配了一整套自己的资料库。
确实豪华,就是太占地方了。
那能不能这样:32 个观察员继续问各自的问题,但是大家共用同一个资料库?
唉,恭喜你发明了 MQA,Multi-Query Attention。
32 个 Q 还在,但 K 和 V,只保留 1 套。
注意啊,共用 K、V,不代表所有头的结果都一样。每个头的 Q 不同,问的问题不同,算出来的注意力权重也就不同。
不过,这一刀砍得有点狠。
32 套直接砍成 1 套,缓存一下子小了很多,Decode 时要读取的数据也少了很多。
可代价也很明显:原来每个头,都可以按自己的方式去组织资料,现在所有人都得读同一份。共享得太激进了一点,模型的表达能力难免要受影响。
这就像公司降本增效:原来 32 个人,每人配一个专属助理,现在老板一刀下去,全公司只留 1 个。省钱是真省钱,可 32 个人排队找同一个助理,谁都用得不顺手。
所以我们自然会想:能不能别这么极端?
既不用 32 套,也不要只剩 1 套。比如留 8 套,每 4 个观察员共用一个资料库,在每人一套和所有人共享一套之间取了一个折中的方案。
这就是 GQA,Grouped-Query Attention,分组查询注意力。
好比裁员也不一定非得一刀切,可以按小组来:每个小组只留 1 个助理,组内的人共用。
我们来对比一下:
MHA,一个头配一套 KV。
MQA,所有头共用一套 KV。
GQA,几个头一组,一组共用一套 KV。
到目前为止,MQA和GQA砍的都是同一个东西:KV 的份数。
每一份缓存,能不能变小?MLA
但是,如果上下文有 100 万 Token,就算从 32 套砍到了 8 套,每个 Token 还是得存自己的那一份。
那能不能换个思路:别光想着少存几套,而是让每一份本身变小?
还是拿“虎皮鹦鹉”这个 Token 来说。
传统做法是:根据它的向量,算出各个头需要的 K、V,原封不动地存进缓存。
可这些又长又宽的 K、V 信息,真的需要原样存下来吗?
能不能先把它们压缩到一个很小的空间里,缓存里只存压缩之后的小东西?
压缩?这能行吗?
我们一个问题一个问题来。先看第一个:为什么能压缩?
注意一个细节。
32 个头的 K 和 V,全都是从“虎皮鹦鹉”这同一个向量变出来的。
它们看起来像几十份各自独立的数据,其实源头只有一个。每个头做的,只是用自己的方式,把这同一份信息重新加工一遍。
所以这几十份 K、V 之间,有大量重复的内容,真正独有的信息,并没有看上去那么多。
就好比一份原稿,复印了几十份,每份只是换了个排版。
你不需要把几十份复印件都存起来,存一份原稿,再记住几十种排版方法,就够了。
那具体怎么压缩呢?
用一个训练出来的线性变换,把“虎皮鹦鹉”的向量,压成一个很短的向量。
这个压缩出来的短向量,叫 Latent,潜在表示。
原来每个 Token 的 K 和 V,加起来要存几千甚至几万个数字。现在只存这个短向量,也就几百个数字。
于是缓存里,“轩辕”存一小份,“养了”存一小份,“虎皮鹦鹉”也存一小份。
可是,用的时候怎么办?
做注意力计算,总得有每个头需要的 K 和 V 才行啊。
这时候,再用一组训练出来的线性变换,把这个短向量重新展开,变回各个头需要的 K 和 V。
关键在这儿:每个头,都有自己专属的展开方式。
所以大家存的是同一份精简笔记,但每个头展开出来的 K、V,是各不相同的。
这和 MQA 完全不一样。
MQA 是所有头被迫读同一份 K、V,结果只能雷同。
而这里是共用同一个源头,每个头仍然可以按自己的方式去解读。
回到我们的比喻:资料库里原来放的是整本整本的书,现在只存一份精简的笔记。32 个观察员拿到的是同一份笔记,但每个人都有自己的读法,各自还原出自己需要的资料。
这套“先压缩着存,用的时候再各自展开”的办法,就是 MLA,Multi-head Latent Attention,多头潜在注意力。
听到这里,估计有兄弟要问了:
压缩了,信息会不会丢?
理论上,会。
压成更短的向量,容量就变小了,不可能一点损耗都没有。
但它和 MQA 那种一刀切的共享,有一个很大的区别:压缩和展开用的这两组变换,不是人工设计的,而是跟着模型一起训练出来的。
模型从头训练的时候,就知道自己的缓存只有这么大。于是它会自己学着,把最有用的信息放进这个短向量里,把重复没用的内容舍掉。
所以在实际效果上,根据 DeepSeek 论文里的实验,MLA 并不比传统的 MHA 差。
压得小,效果还能保持得不错,这就是 MLA 的厉害之处。
不过真实的 MLA,还是比较复杂,这里只是一个简化后的描述,大家理解这个意思就好了。
到现在为止,MQA和GQA解决了KV Cache份数太多的问题,MLA解决的是K和V太臃肿的问题。
可是,你想一下。
如果上下文有 100 万个 Token,就算每个 Token 都瘦得像根牙签,那也是 100 万根牙签啊,算起来还是费劲。
那么我们能不能让这些“牙签”——也就是K和V本身少一点呢?
历史太多,能不能不全看?DSA
假设现在的上下文特别长。
最前面有一句:轩辕小时候养了一只虎皮鹦鹉。
后面聊了几十万个 Token,从天文地理聊到世界大战,从诗词歌赋聊到人生哲学。
最后,突然来了一句:轩辕小时候养的是什么?
如果是你来回答,你会把前面几十万个字,每个字都重新仔细看一遍吗?
当然不会。
我们是先快速扫一遍,找到和这个问题相关的几处,然后只精读那几处。很快就找到了“虎皮鹦鹉”。
那模型能不能也这么干?
别对 100 万个历史位置,都做昂贵的精确注意力。
先用一个便宜的办法,给所有历史位置快速打个分,然后只挑分数最高的一批,比如 Top-K。
真正昂贵的注意力,只在这些候选位置里面算。
先粗筛,再精算。
恭喜你发明了DSA:DeepSeek Sparse Attention 。
它里面有一个 Indexer,你可以把它理解成一个轻量级的检索器,专门负责前面那步粗筛。
听到这里,估计有兄弟要问了:
训练数据千变万化,“虎皮鹦鹉”今天可能出现在第 3821 个 Token,明天可能出现在第 80 万个 Token。这个 Indexer 到底怎么训练?
关键在于:位置是随机的,但“什么内容和当前问题相关”,并不是随机的。
普通的注意力,学的也不是“永远去看前面第 5 个 Token”,而是什么样的 Q 和什么样的 K 更匹配。
Indexer 也是一样,它学的不是位置,是相关性。
而且 Indexer 还有一个很大的优势:它不需要预测得特别精确,它只负责筛候选。
假设真正重要的 Token 只有几十个,Indexer 给你捞回来 2000 个,里面混进了一大堆没用的,也没关系。
因为后面的正式注意力,会在这 2000 个里面重新计算、重新做 Softmax、重新决定到底给谁多少权重。
只要真正重要的那几十个,没有漏在外面就行。
所以对 Indexer 来说,最重要的指标是召回率。
宁可多抓几个,也别漏掉关键的。
到这里,DSA 的思路就清楚了。
MLA 是让每个历史 Token 变瘦。
DSA 则是:历史 Token 再多,我只挑重要的看。
但是,新的问题又来了。
为了从 100 万个 Token 里面挑出 Top-K,Indexer 自己面对的候选池,不还是 100 万个吗?
粗筛虽然比精算便宜得多,可 100 万终究还是 100 万。
能不能再砍一刀?
连挑选的范围都太大?CSA
Indexer 的候选池太大,那最直接的办法,就是先让候选池变小。
怎么变小?
还是假设有 100 万个历史 Token。
我们可以先把连续的几个 Token,合并成一个,再让 Indexer 去挑。
为了方便理解,我们假设每 4 个合并成 1 个。
“轩辕 / 养了 / 一只 / 虎皮鹦鹉”,原来占 4 个位置。现在通过一个训练出来的压缩过程,把这 4 个位置的信息融合成 1 个更浓缩的表示。
合并出来的这些浓缩条目,叫 Compressed Entry。
于是 100 万个 Token,按 4 比 1 合并,就只剩 25 万个条目。
接下来,再让 Indexer 从这 25 万个条目里,去挑重要的。
这相当于砍了两刀。
第一刀,先把历史压短。
第二刀,再从压缩后的历史里挑着看。
先压缩,再稀疏。
这个办法,就是 CSA,Compressed Sparse Attention。
名字里,其实已经把答案写出来了。
这里特别容易和 MLA 搞混,因为两边都叫“压缩”。
但它们压的方向完全不一样。
我们把历史缓存想象成一张很长的表格。
横着看,是每个历史位置要存多少信息。
竖着看,是一共有多少个历史位置。
MLA 是横着压:每个 Token 原来很宽,现在把它压窄。
CSA 是竖着压:原来有 100 万行,现在多个位置合成一行,行数变少了。
所以 MLA 把缓存压窄,CSA 把历史压短。
不过,新的问题又来了。
4 个 Token 压成 1 个,信息难道不会丢吗?
当然会。
多个位置的信息融合成一个,肯定不可能和原来一模一样。
所以这种压缩,本质上是拿一部分信息精度,去换效率。
一个很自然的思路就是:
离得远的内容,看压缩后的“摘要”就行。
但离当前 Token 很近的内容,还是保留更精细的原始信息。
这就像我们读一本特别厚的书。
几百页以前的内容,脑子里可能只剩个大概。
但刚刚读过的最近几页,细节还记得清清楚楚。
你看,长上下文的注意力优化,越来越像我们翻书找东西的过程了:先翻目录,再精读,远处只记摘要,近处看得仔细。
回顾总结
OK,到这里,让我们把所有技术重新串一遍。
你会发现,这些缩写突然就没那么吓人了。
最开始,每生成一个 Token,如果历史的 K、V 都重新算一遍,太浪费了。
怎么办?
KV Cache。算过的别再算。
接着发现,历史 K、V 虽然不重复算了,但缓存越来越大。
怎么办?
MQA 和 GQA。让多个头共用 KV,少存几套。
套数是少了,可每个 Token 要存的信息还是很多。
怎么办?
MLA。压一压,每个存小一点,把缓存压窄。
然后发现,每个 Token 已经很瘦了,可历史有 100 万个。
怎么办?
DSA。别全看,先粗筛,再只挑重要的看。
可是,粗筛的时候要面对的候选,还是 100 万个。
怎么办?
CSA。先把历史压短,再从里面挑着看。
为什么今天的大模型,可以轻松处理几十万、上百万 Token,却没有被注意力的成本拖垮?
靠的不是某一个单独的技术,而是一整套技术,每个方向都在省一点。
那为什么宣传百万上下文的模型,用到五六十万,就开始降智了?
原因肯定不止一个。比如训练数据里,真正很长的文本本来就少。
再比如和我们今天讲的内容有关:这些省钱的办法,大多不是白省的。
压缩,会丢信息。
挑着看,可能把真正重要的那一条漏在外面。
上下文越长,需要压缩的越多,需要筛选的越多,漏掉关键信息的概率,也就越大。
省下来的每一分算力,背后都是拿一点精度换的。
这就像公司降本增效,砍得越狠,业务出问题的风险也就越大。
回头看,2017 年 Transformer 刚出来的时候,注意力最大的优势,就是让所有 Token 直接建立联系,不用像 RNN 那样一个一个传话。
可是当上下文从几十、几百个 Token,一路涨到几十万、上百万个,“所有 Token 都能看到所有 Token”这个最大的优势,反过来又变成了最大的成本。
所以这些年注意力技术的演进,一直在两头之间找平衡:既要保住注意力强大的信息检索能力,又要想尽办法,把计算、显存和带宽的成本压下来。
而且这条路,显然还远远没有走完。
今天是 100 万 Token。
如果以后来到 1000 万,甚至更长,注意力还会是今天这个样子吗?
模型又会用什么办法,去保存和检索如此庞大的历史信息呢?
是采用更加先进的架构和算法,还是靠硬件算力的进步大力出奇迹来解决呢?
大家可以来开开脑洞,评论区分享一下你的看法。
OK,以上就是今天视频的全部内容了,视频制作不易,如果觉得有用,别忘了一键三连,点赞越多,更新越快。
我是轩辕,我们下期再见。