猜水果游戏
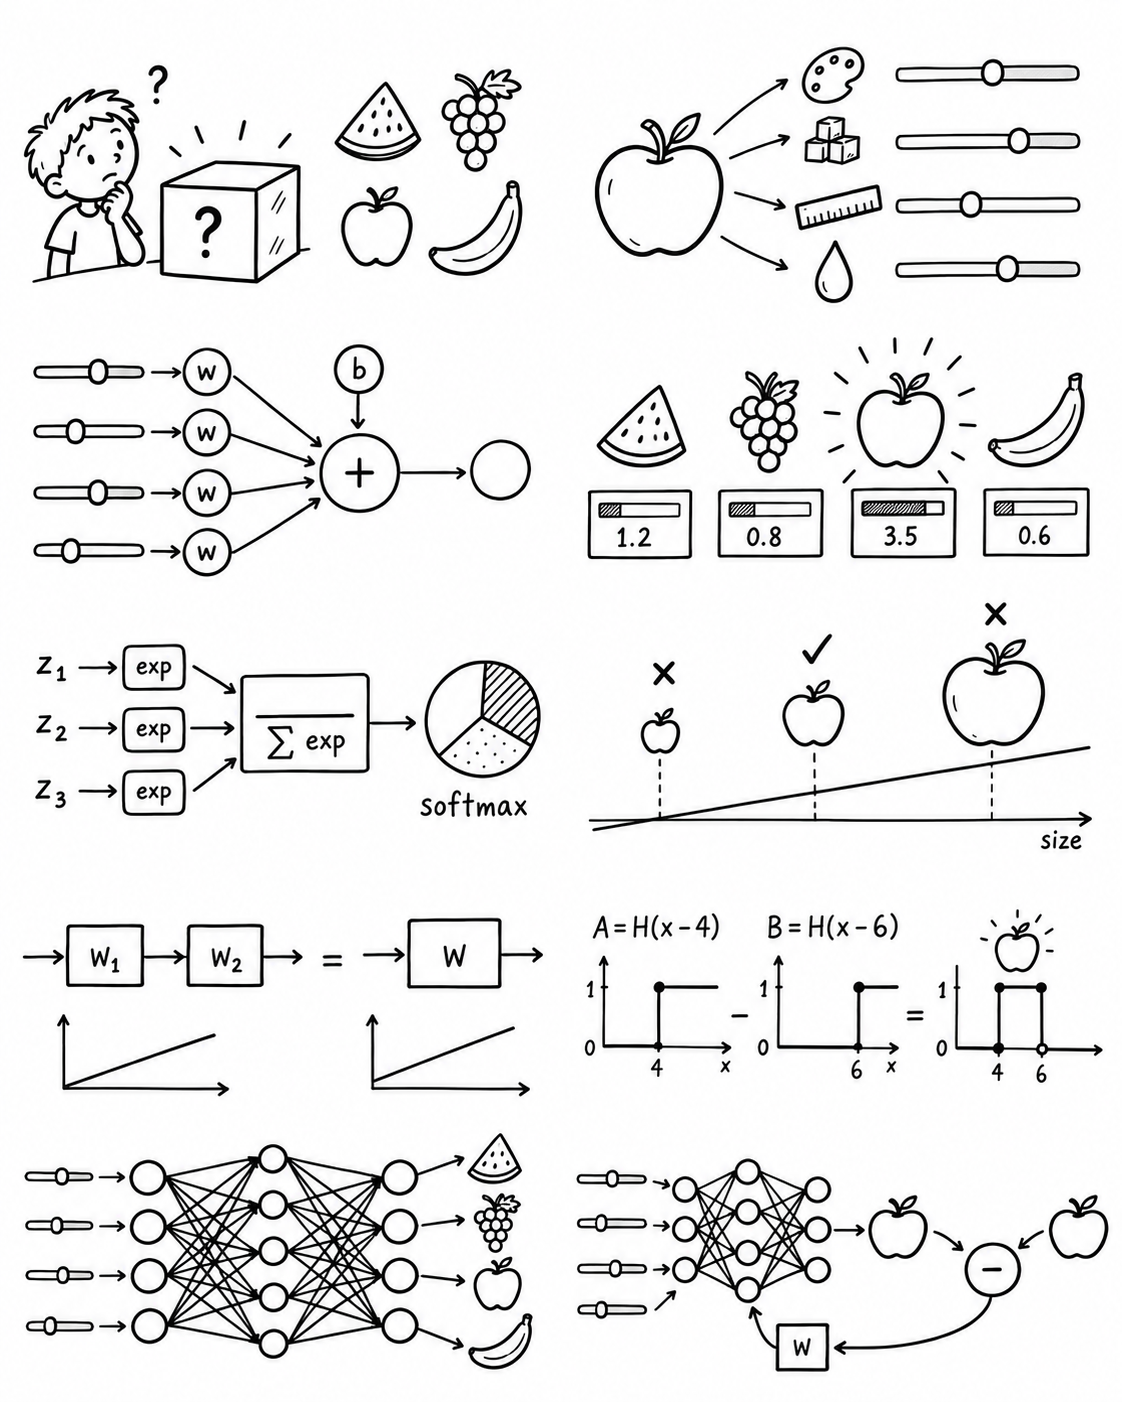
这个盒子里有一个水果,现在有四条线索,它是红色的,很甜,个头中等,水分不是特别多,你来猜猜看,这可能是下面哪种水果?
A、西瓜
B、葡萄
C、苹果
D、香蕉
这简直是送分题,你几乎不假思索的就知道那是苹果,因为西瓜是绿色的,香蕉是黄色的,葡萄又太小,剩下的就只有苹果了。
想一想,如何让计算机来完成这个猜水果的游戏呢?
计算机可无法理解个头中等是什么意思,很甜是有多甜,水分不是特别多那是有多少?
计算机只能处理数据,我们得给它量化一下。
比如每条线索都用 1 到 10 之间的一个数打分。
颜色,越红分越高,这个 9,相当红
甜度,7,挺甜
个头大小,5,中等
水分,5,一般。
现在游戏变成了通过告诉计算机这四个数字,让它猜出这是什么水果。
这个难度还是大了一点,再简化一下,分成4个子任务:
1、通过这四个数字分析是不是西瓜
2、通过这四个数字分析是不是葡萄
3、通过这四个数字分析是不是苹果
4、通过这四个数字分析是不是香蕉
现在每个问题只需要判断是或者不是即可,只要有一个判定结果是YES,那就知道答案了~~~~。
我们以苹果为例,给计算机这四个数字,9、7、5、5。它要怎么从这四个数,判断出「是苹果」还是「不是苹果」?
回想一下你自己刚才是怎么思考这个问题的?
你可能没意识到,其实你的大脑做了一次加权求和打分。
「又红又甜」最像苹果,所以颜色和甜度这两条,你心里分量给得重。
大小和水分嘛,参考一下就好,分量轻。
我们把这个「分量」也量化一下变成权重,还是以1-10分来打分,颜色很重要7分,甜度也很重要 6分,大小和水分相对来说不是那么重要给个3分吧。
这里插一句啊,不管是前面线索的分数还是这里各个线索权重的分数,都是咱们凭直觉拍脑袋定的,你完全可以换一组数字,或者更看重个头和水分,这些都可以,不用太在意,get这个意思就好。
然后对每个线索进行加权求和打分
9x7 + 7x6 + 5x3 + 5x3 = 135
得到 135。这个分数算高吗?到底多少分才算苹果?光有分数、没有一条「门槛线」,根本没法下结论。
我们可以再算一个明显不是苹果的:一个又小、又绿、又酸的青果子(当然这里咱们不考虑青苹果的情况)。
颜色,2,青色
甜度,2,非常苦涩
个头大小,2,很小
水分,4,一般。
同样的计算方法代进去,2x7 + 2x6 + 2x3 + 4x3=44
算出来大概是 44。135,一个44,那门槛线,大概在中间,还是拍脑袋取个平均值吧:90分。
只要加权求和结果超过90分,那就判定是苹果,否则就不是。
但每次都得记着「跟 90 比一下」,太别扭,再进一步,直接把这个门槛塞进公式:加权求和总分减掉 90,如果大于 0,就是苹果。
现在这台机器已经可以判断苹果了,我们按照同样的方法,为剩下的西瓜、葡萄、香蕉都设定各自的一组权重值和门槛值,现在就能完成这四种水果的判断了。
我们把一个猜水果的游戏变成了一个计算机也可以玩的数学游戏,有点意思吧?
但作为一个判断水果的机器,最终得要有一个结论,到底是哪种水果?也就是说,这四个独立判断的结果需要汇总后,输出一个最终的结论。
Softmax
最省事的办法当然是:谁分最高就选谁,苹果 +45分 遥遥领先,选它。
可这么干有个别扭的地方,这几个分数代表什么意思?45分到底代表有几成把握?不太看得出来。
最好能够把这四个分数,换算成百分比,变成一个概率,代表各自有多少把握,加起来正好等于 100%,哪个最高就是哪种水果,这样更清楚明白。
那怎么从分数换成百分比?
很简单:每个分数除以四个分数的总和,就得到各自的占比,加起来不就等于 100%了吗?
但问题是这里的分数有正有负,没法这样干,得把它们先转成正数才行。
但也不能直接取绝对值,+45和-45,两个数绝对值一样,但代表的意思却截然相反。
那怎么办呢?
高中学过一个东西,指数函数,不管喂进去正、负、还是零,它吐出来的永远是正数。
当输出是正数的时候,正数越大,代表是某个水果的可能性越高,输出值也越高。
当输出是负数的时候,负数越小,代表是某个水果的可能性越低,输出值越贴近0。
这不正好嘛!
于是流程就清楚了:把四个分数各自送进指数函数,负的被压到接近 0、正的被放大,全成了正数;再除以它们的总和就可以了,得到了每种水果的可能性概率,加起来就是100%。这套「先取指数、再归一化」的操作,就叫 Softmax。
现在这套机器就能根据输入水果的四个维度的参数信息,给出四种水果对应的概率了!
激活函数
但现在这个机器还有个非常大的问题。一个真正的好苹果,个头是中等的,5 分上下;太小的不是苹果,太大的也不是。换句话说,「是苹果」对应的是个头的中间一段,两头都该判「不是」。
但我们现在是加权求和,就意味着个头分数越大,判断结果就越倾向苹果,这么一根筋可不行。
比如来个10 分的超级大家伙,明明不是苹果,但分数比 5 分的真苹果还高,机器反倒更起劲地判它是苹果,明显错了。
问题出在哪里呢?
我们把问题简化一下,四个维度中,只看一个,比如只看个头大小。
这个时候,分数判定公式就是一个一次函数。画在平面直角坐标系里,就是在平面上找一条直线、把平面一刀切成两半——一边判「是」,一边判「不是」。
一刀切,天然只能切出「比某个值大」或者「比某个值小」,它永远切不出「夹在某两个值中间」的那一部分。
可能有人觉得,你只考虑个头大小肯定是这样啊,这不还有其他线索条件限制吗?
那我们再加一条线索,分数判定公式就变成了一个二元一次函数。
加了一个维度,在空间坐标系里,这就是一个平面,它同样是直的,不会拐弯,之前的问题依然存在。
再加维度道理也是一样,只不过我们没法画出来,只能靠想象了,它依然只是高维空间里面的一个超平面。
那怎么办呢?一台判断器只会切一刀,那我多叠几台、一层接一层,让它们合伙切出复杂的形状,行不行?
第一层 h=W1x+b1
第二层 y=W2h+b2
y=W2(W1x+b1)+b2=(W2W1)x+(W2b1+b2)
为了简单理解,还是只考虑一个维度。
第一层做一次「加权求和」,第二层拿它的结果再「加权求和」。把这俩合并、化简一下会发现,结果还是一次加权求和。叠两层等于一层,叠一百层也还是等于一层。除了增加计算量,其他啥也没改变,还是只能一刀切。
要解决这个问题,单纯靠堆层数是没用的,必须得卷起来!
我们需要一个函数,**它接在「加权求和」的后面,**把这里的输出从线性传导变为非线性传导,这样就能把原来的直线给掰弯了。
为什么「掰个弯」就能成?
咱们还是拿「个头大小」这条线索举例,假设把苹果的个头,就定在 4 到 6 分这一段。
这里先用一种最简单粗暴的非线性函数,阶跃函数:这个函数很简单,小于 0 就输出 0,大于等于0 就输出 1。
我们用两层结构来解决这个问题:
第一层放两台判断器:
判断器A负责检测「个头够大了吗」:个头一旦过了 4 分就输出 1,否则输出0。
判断器B负责检测「个头是不是太大了」:个头一旦超过 6 分就输出1,否则输出0。
第二层就一步:把两个结果相减,最终分 = A − B。
现在代入三个数字进去看一下:
个头 2 分(太小):A = 阶跃(2−4) = 0,B = 阶跃(2−6) = 0,最终 0 − 0 = 0,判:不是苹果 ✓
个头 5 分(正好):A = 阶跃(5−4) = 1,B = 阶跃(5−6) = 0,最终 1 − 0 = 1,判:是苹果 ✓
个头 8 分(太大):A = 阶跃(8−4) = 1,B = 阶跃(8−6) = 1,最终 1 − 1 = 0,判:不是苹果 ✓
成了!单台判断器死活搞不定的「中间一段」,两台一组合,轻轻松松就框了出来。
而点睛之笔,全在那个非线性函数上。我们把它撤掉再算一遍试试:A 就是 (个头 − 4)、B 就是 (个头 − 6),A − B = (个头−4) − (个头−6) = 2,永远是个 2,雷打不动的常数,啥也判断不了,这正是前面说的「不管叠几层,实际上都等于一层」。
就是这「非线性」的一掰,才解决了线性解决不了的问题。
直来直去很多时候解决不了问题,有所变通,才能更好拟合这个世界。
这个接在加权求和后面的非线性函数,就是激活函数。这里是一些常见的激活函数。
当然,阶跃函数太「硬」了,非 0 即 1。实际中更常用一些「软」一点的。
把判断器叠成很多层、每层后面都跟上这么一道「掰弯」的激活函数,不管是圆的,扁的,任意奇形怪状的判断边界,机器都能拼出来。
到这一步,我们把一个猜水果的游戏,彻底变成了计算机可以一步步算出来的数学游戏。完美!
揭晓:你刚刚到底造了个什么
好了,憋了这么久,估计大家应该都猜出来了。
咱们上面造的这台机器就是大名鼎鼎的神经网络。
而我们最初造的那个最小的判断单元:几个输入,各乘一个权重,加起来,减一个门槛,再过一道激活函数。这个小东西,就是神经元。它的灵感来自人类大脑里的生物神经元,从上游收一堆信号,攒够了就「激发」、传给下游。当然,这里只是一个理想化简化后的模型,真实的人脑神经元可比这复杂得多。
再看我们把四个神经元(西瓜、葡萄、苹果、香蕉各一个)并排站成一排,这一排就叫一层。要是把很多层叠起来,前一层的输出喂给后一层,这整张东西就组成了神经网络。
最前面这一层叫做输入层,最后这一层是输出层,中间这些属于隐藏层。
你可以把神经网络理解成一个函数,和我们中学阶段学的那些函数本质上并没有什么不同,完成的工作就是把输入的参数映射到结果集的工作,也就是定义域到值域的映射过程。
只不过和中学阶段学过的这些函数不同的是,我们很难用一个具体的数学表达式去写出这个函数。而是用无数个线性和非线性计算拼凑出来,实现这个效果。
今天大家都在用的大语言模型ChatGPT、Claude,本质上也不过是把这套零件,堆了几千亿个而已,每一个神经元做的,还是你刚才那套「加权、求和、减门槛、过激活」的流程。
可这台机器,还不会自己「学」
但是,到目前为止——这台机器现在其实还只是个玩具。
前面我们说过,这个神经网络里的那些权重、偏移,全是咱们拍脑袋定的,如果换一批苹果、换个产地,这些数可能就完全不对了。
最好是不要凭借经验或者拍脑袋定,而是去找一大堆各种各样的苹果,把它们的这四个维度的值都提取出来,一个一个输入这台机器,然后不断地调整这些权重值和门槛值,直到它能完美契合所有的苹果为止。
但人工去做这事,效率实在太低了,而且我们这里才四个维度,实际上的神经网络输入的参数维度可能成千上万,加上多层叠加嵌套,所有权重偏移数量加起来是个天文数字,人工去调整,根本不现实。
能不能让机器自己去调整呢?
这个「让机器自己把参数调到最好」的过程,就是神经网络的训练过程,正是它,让一台拍脑袋定的玩具,真正变得聪明起来。
下期视频,我们一起来看看这又是怎么实现的。
这个系列视频,我将用小白友好的方式,把我理解的人工智能背后的工作原理分享给大家。从基础数学、神经网络,到自然语言处理技术发展历史到Transformer大语言模型架构,从最简单的问题出发,带着大家一起学习。
如果你喜欢我的讲解方式,别忘了来一个点赞投币转发,你们的支持是我更新的动力。
我是轩辕,我们下期再见。